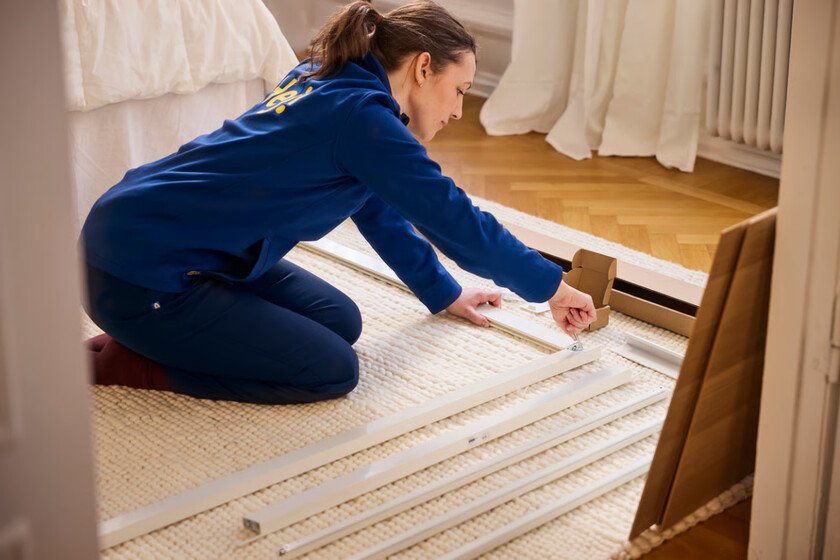
Epoch AI ha realizado un avance significativo en el desarrollo de inteligencia artificial (IA) aplicada a tareas de ensamblaje de muebles. La empresa llevó a cabo un experimento utilizando muebles de IKEA, en el que intencionadamente cometió errores durante el montaje. Fotografías de estos montajes, junto con los manuales de instrucciones, fueron analizadas por diferentes modelos de IA para determinar si los muebles estaban ensamblados correctamente y, en caso contrario, identificar los errores.
En un periodo de diez meses, la precisión de los modelos en el Furniture Assembly Benchmark (FAB) pasó del 28% al 80%. En noviembre de 2025, el modelo Claude 4.5 era el mejor, alcanzando un 28% de aciertos. Para septiembre de 2026, GPT-6 Astra logró un 80% de aciertos, además de reducir el tiempo de análisis a una media de tres minutos por imagen, lo que representa entre dos y diez veces menos tiempo comparado con modelos anteriores.
El proceso de evaluación no se limita a observar una imagen; los modelos de IA deben examinar una fotografía del mueble parcialmente montado, el manual de instrucciones de IKEA, y hacer uso de herramientas para incrementar el zoom en ciertas partes de la imagen. Esto les permite conectar diagramas del manual con componentes reales, evaluando así el proceso de montaje y destacando errores, como el posicionamiento incorrecto de piezas. Epoch AI introdujo intencionalmente errores en el montaje para dificultar la tarea de la IA.
La finalidad de este experimento no es solo evaluar la precisión en el ensamblaje, sino también explorar la capacidad de razonamiento abstracto de la IA. Esta habilidad es fundamental para que en el futuro, modelos de inteligencia artificial puedan asistir en la reparación de aparatos o en la resolución de problemas técnicos en dispositivos cotidianos. Aunque evaluar el rendimiento de la IA en tareas matemáticas o de programación es relativamente sencillo, los desafíos aumentan cuando se trata de visión y razonamiento espacial aplicados a la vida real.
A pesar de los progresos, aún estamos lejos de contar con robots que realicen ensamblajes de manera autónoma. Este benchmark se centra en la capacidad de la IA para observar y verificar montajes realizados por personas, no en su habilidad para planificar y ejecutar el proceso de ensamblar un mueble desde cero. Reconocer que una pieza está mal colocada no implica que una máquina sea capaz de manipular las piezas ni de resolver errores inesperados.
Durante el análisis, Epoch AI también identificó sesgos en las familias de modelos utilizadas. Por ejemplo, los modelos Gemini y Qwen tendían a asumir que siempre había errores, mientras que otros modelos, como los de OpenAI y Anthropic, a veces confirmaban montajes incorrectos. Resultó crucial equilibrar la búsqueda de errores con la identificación de situaciones correctas.
El experimento recalca un tema importante en la inteligencia artificial: medir el rendimiento de estos modelos en situaciones ambigüas presenta mayores desafíos. A menudo, se observa que la IA puede resolver problemas complejos mientras encuentra dificultad en tareas aparentemente simples, un fenómeno conocido como la paradoja de Moravec.